
Le marché des paris sportifs a définitivement basculé dans une ére purement quantitative en 2026. Fini le temps où les probabilités reposaient sur l'intuition d'un expert ou le simple flair d'un bookmaker. Si vous vous demandez exactement comment l'apprentissage supervisé modifie l'analyse des cotes, la réponse tient en une promesse : une précision chirurgicale. Les opérateurs se sont métamorphosés en véritables data scientists, exploitant des montagnes de données étiquetées pour anticiper chaque scénario avec une exactitude redoutable.
Aujourd'hui, le trading algorithmique dicte sa loi sur les plateformes. Ce moteur technologique ingère des millions de variables historiques pour modéliser la probabilité de victoire attendue en temps réel. L'objectif n'est plus seulement d'estimer un résultat final, mais de gérer le risque financier à la milliseconde près. Cette révolution relègue les anciennes méthodes statistiques aux oubliettes, imposant une nouvelle norme où la machine détermine la valeur absolue d'un événement sportif.
En bref
L'apprentissage supervisé transforme radicalement le trading sportif grâce à une précision algorithmique inégalée.
- Remplacement des modèles statistiques rigides par des algorithmes de gradient boosting (XGBoost, LightGBM).
- Exploitation massive de données étiquetées pour modéliser des scénarios complexes en temps réel.
- Amélioration de 5 à 8 % de la précision prédictive par rapport aux méthodes classiques.
- Passage d'une analyse statique à une gestion dynamique du risque à la milliseconde près.
- Capacité supérieure à intégrer des variables non linéaires et contextuelles pour limiter l'incertitude.
De la loi de Poisson au Gradient Boosting : une rupture technologique
Pendant des décennies, les cotateurs se sont appuyés sur des formules mathématiques rigides. Le modèle de Poisson régnait en maître pour estimer le nombre de buts ou de points lors d'une rencontre. Cette approche purement statistique, bien que robuste, manquait cruellement de flexibilité face aux imprévus du direct.
Le changement de paradigme s'opère avec l'intégration massive des algorithmes de régression avancés. Des architectures comme XGBoost ou LightGBM ne se contentent plus de calculer des moyennes historiques. Elles ingèrent des millions de données étiquetées pour comprendre le contexte exact d'une action sportive. Pour que ces algorithmes fonctionnent, une organisation rigoureuse de vos fichiers de données est indispensable.
Chaque passe, chaque blessure ou variation météorologique agit comme un label d'apprentissage. Cette granularité offre aux opérateurs une capacité inédite de gestion du risque en temps réel. L'ajustement d'une probabilité de victoire au tennis, par exemple, s'effectue désormais à la milliseconde près en fonction de la dynamique de l'échange.
Les instituts de recherche en sciences du numérique, à l'image d'Inria, soulignent d'ailleurs comment ces modèles prédictifs redéfinissent les mathématiques appliquées. La machine ne devine plus le résultat final : elle cartographie l'incertitude en continu pour verrouiller les marges financières des plateformes. Dans ce contexte de haute précision technologique, il devient indispensable de savoir mesurer la fiabilité de vos algorithmes de pronostics pour espérer rivaliser avec les outils d'analyse des bookmakers.
Les limites de la distribution de Poisson traditionnelle
Le modèle de Poisson a longtemps fait illusion, mais son architecture mathématique craque sous le poids du sport moderne. Son principal défaut réside dans son incapacité totale à traiter les variables non linéaires et les interactions complexes. Concrètement, cette formule isole les événements. Elle ignore qu'une pelouse détrempée combinée à la fatigue d'un défenseur central crée une synergie désastreuse sur le terrain.
Cette approche souffre également d'une dépendance excessive aux moyennes historiques. Elle fige le calcul sur des performances passées, totalement dénuées de contexte dynamique. Si une rencontre s'emballe soudainement, l'équation reste aveugle au momentum. Les travaux d'institutions scientifiques majeures comme le CNRS démontrent d'ailleurs que les statistiques classiques peinent à modéliser l'imprévisibilité des systèmes complexes en temps réel.
Le constat est encore plus sévère dans les disciplines à faible score comme le football ou le hockey. La formule lisse les courbes et provoque une sous-estimation des événements rares. Un carton rouge précoce ou un score fleuve font instantanément dérailler le calcul. C'est précisément pour combler ces failles que les algorithmes modernes ingèrent massivement des données étiquetées, transformant chaque anomalie statistique en un nouveau standard prédictif.
La puissance du Gradient Boosting avec XGBoost et LightGBM
Pour surpasser les modèles statistiques classiques, les data scientists déploient des algorithmes d'arbres de décision surpuissants. Des architectures comme XGBoost et LightGBM se distinguent par leur capacité à traiter des milliers de variables d'entrée simultanément. Météo, historique des confrontations ou temps de jeu récent : chaque micro-donnée est croisée en une fraction de seconde.
Leur secret réside dans l'optimisation continue de la fonction de perte. À chaque itération, le modèle corrige ses propres failles pour réduire drastiquement l'erreur quadratique moyenne. Cette mécanique d'apprentissage itératif offre une fiabilité redoutable, souvent supérieure aux réseaux de neurones classiques lorsqu'il s'agit de structurer des données tabulaires pures.
Les résultats sur le marché du trading sportif sont sans appel. En 2026, l'utilisation de ces techniques de pointe génère une amélioration de 5 à 8 % de la précision des prédictions de score final. Une avancée technologique majeure que des institutions d'excellence comme l'École Polytechnique étudient de près pour modéliser la gestion du risque en temps réel.
Comparaison des performances : modèles classiques vs IA supervisée
Le gouffre technologique entre les anciennes équations et les algorithmes modernes saute aux yeux lorsqu'on confronte leurs métriques. En 2026, la gestion du risque en direct exige une réactivité foudroyante que seules les machines nourries aux données étiquetées peuvent garantir.
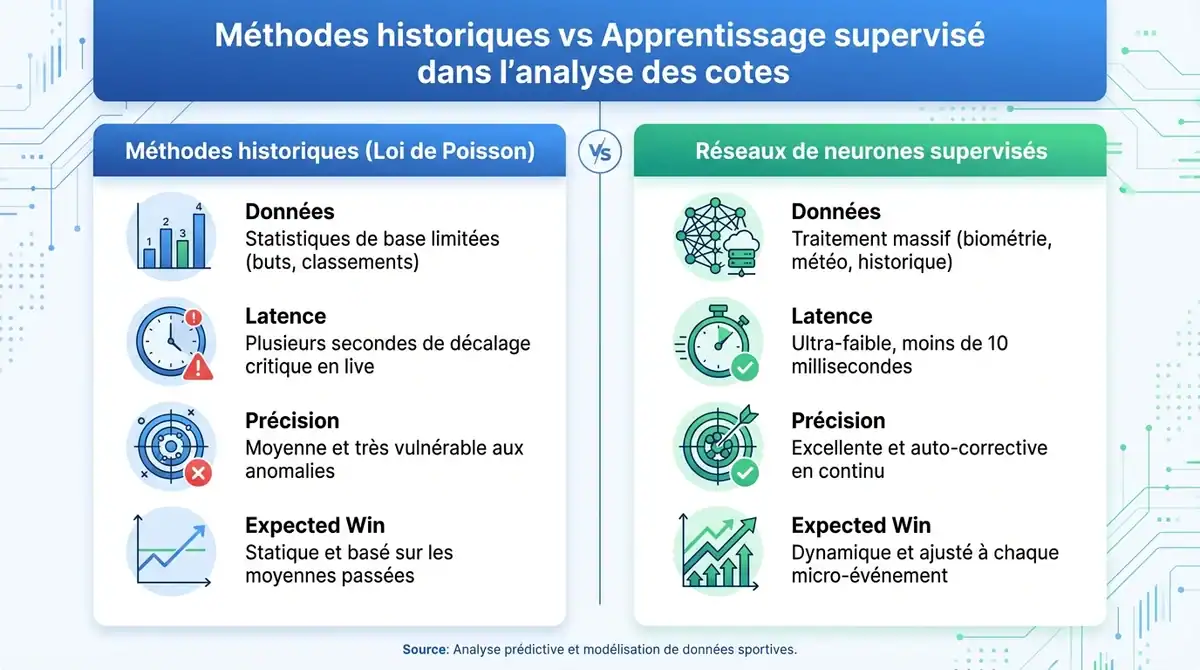
| Indicateur | Méthodes historiques (Loi de Poisson) | Réseaux de neurones supervisés |
|---|---|---|
| Volume de données traitées | Limité aux statistiques de base (buts, classements) | Massif (météo, biométrie, historique croisé) |
| Latence de calcul | Quelques secondes (décalage critique en live) | Moins de 10 millisecondes |
| Précision prédictive | Moyenne, très vulnérable aux anomalies | Excellente, auto-corrective en continu |
| Calcul de la Expected Win | Statique, basé sur les moyennes passées | Dynamique, ajusté à chaque micro-événement |
La véritable rupture s'observe sur le calcul de la Expected Win (probabilité de victoire attendue). Là où les statistiques traditionnelles figeaient leurs scénarios avant le coup d'envoi, le machine learning réévalue les rapports de force à la milliseconde.
Chaque passe réussie ou accélération soudaine devient un label qui affine instantanément la prédiction finale. Des instituts de recherche de pointe comme l'INRIA valident d'ailleurs la supériorité écrasante de ces architectures neuronales pour modéliser l'incertitude sportive avec une précision chirurgicale.
L'apprentissage par renforcement dans les paris sportifs : l'avenir des stratégies dynamiques
Au-delà de l'analyse prédictive supervisée, l'apprentissage par renforcement (Reinforcement Learning) révolutionne la prise de décision séquentielle. Dans un environnement hautement incertain comme le pari sportif, cet algorithme agit comme un agent autonome qui apprend par essai-erreur. Il ajuste ses actions grâce à un système de récompenses et de punitions virtuelles.
Plutôt que de simplement estimer une probabilité fixe, les modèles de Reinforcement Learning optimisent la maximisation des gains à long terme. Ils adaptent instantanément la taille des mises et les stratégies d'arbitrage en temps réel durant le live betting, offrant une réactivité optimale face aux variations de cotes.
Le backtesting de stratégie dans les paris sportifs : valider vos modèles algorithmiques
Avant d'engager du capital réel, le backtesting d'une stratégie de paris sportifs s'impose comme une étape de validation indispensable. Cette méthode consiste à simuler les performances d'un algorithme en l'appliquant rétrospectivement sur des bases de données historiques exhaustives.
En analysant un échantillon représentatif de plusieurs centaines de rencontres, le parieur quantitatif évalue la rentabilité réelle et la stabilité de son modèle d'apprentissage supervisé. L'enjeu majeur réside dans la prévention du sur-ajustement (overfitting), un piège fréquent où le système sur-optimise ses règles sur le passé mais échoue en direct. Un backtesting rigoureux sécurise ainsi vos investissements algorithmiques.
Scraping des cotes de paris sportifs en Python : alimenter vos modèles prédictifs
Pour entraîner un modèle d'apprentissage supervisé performant, la collecte de données historiques et temps réel est une étape fondamentale. Le scraping de cotes de paris sportifs avec Python s'impose comme la méthode incontournable des data scientists pour automatiser cette acquisition. Grâce à des bibliothèques comme BeautifulSoup, Selenium ou Scrapy, vous pouvez extraire les variations de lignes sur des comparateurs réputés tels qu'Oddsportal ou directement depuis les interfaces des bookmakers.
Ces scripts développés en Python alimentent une base de données structurée. Ces métriques nettoyées et étiquetées permettent d'identifier les value bets et d'ajuster en continu vos algorithmes prédictifs face aux mouvements du marché.
Algorithmes et bots surebet : l'automatisation de l'arbitrage de cotes
L'utilisation d'un bot surebet propulsé par un algorithme d'apprentissage automatique transforme l'arbitrage sportif en une discipline quantitative à haute fréquence. Ces robots d'analyse scannent en permanence les écarts de cotation entre dizaines d'opérateurs pour détecter des opportunités de profit garanti sans risque, avant que le marché ne se rééquilibre.
Grâce aux modèles prédictifs et au traitement ultra-rapide des flux de données, l'algorithme d'arbitrage calcule instantanément la répartition de mise optimale et exécute les prises de position en quelques millisecondes. Face aux outils de détection sophistiqués des bookmakers, ces bots intègrent désormais l'apprentissage supervisé pour ajuster leurs schémas de pari et pérenniser leurs rendements.
Analyse de sentiment et NLP : transformer le texte web en indicateur de cote
Au-delà des métriques chiffrées, le traitement du langage naturel (NLP) apporte une dimension qualitative essentielle à l'analyse prédictive. En scannant en continu les réseaux sociaux comme Twitter, les flux d'actualités et les déclarations de presse, les algorithmes quantifient l'état d'esprit général autour d'une équipe.
Cette analyse de sentiment pour les paris sportifs transforme ces volumes de texte non structuré en variables numériques exploitables par les modèles d'apprentissage supervisé. Malgré la difficulté pour le NLP de détecter le sarcasme des supporters, l'agrégation de ces données comportementales permet de détecter très tôt les mouvements de cotes engendrés par des rumeurs ou des annonces de blessures.
Micro-betting et biométrie : l'exploitation des données granulaires
Le live betting a muté. En 2026, l'explosion du micro-betting exige une granularité d'information totalement inédite. Parier sur la prochaine touche ou le prochain ace ne repose plus sur l'intuition, mais sur un flux continu de données étiquetées.
Chaque micro-événement ou signal biométrique capté sur le terrain devient un label précieux pour les algorithmes de régression. Les modèles ingèrent ces variables à la volée pour ajuster les cotes toutes les 200 à 500 millisecondes. C'est ici que l'apprentissage supervisé déploie toute sa force de frappe, atteignant 70 % à 80 % de précision prédictive.
Les flux officiels retransmis via la télévision sur IP et validés par des instances mondiales comme la FIFA fournissent cette matière première brute. Pour les parieurs professionnels, structurer cette avalanche d'informations nécessite des outils d'assistance avancés, d'où l'intérêt de comprendre comment bien configurer ChatGPT paris sportifs pour optimiser vos analyses préparatoires.
Cette captation chirurgicale transforme radicalement la gestion du risque en direct. L'opérateur ne subit plus le match : il anticipe la prochaine action avec une marque d'erreur infinitésimale.
Le tracking X, Y, Z et le traitement des données de mouvement
Les capteurs optiques et les puces RFID transforment les stades en gigantesques matrices de données. En 2026, un match de football génère plusieurs milliards de points de données spatio-temporelles grâce au suivi spatial des athlètes. Chaque course, chaque accélération ou changement de direction est instantanément numérisé sous forme de coordonnées X, Y et Z.
En ingérant ces flux continus, l'apprentissage supervisé parvient à prédire l'issue d'une action avec une latence de quelques millisecondes. Les modèles comme XGBoost s'appuient sur des millions de séquences historiques étiquetées pour anticiper une passe décisive avant même que le ballon ne quitte le pied du joueur. Des institutions scientifiques majeures comme le CNRS étudient d'ailleurs l'optimisation continue de ces calculs ultra-rapides appliqués au traitement du signal.
Cette vélocité algorithmique redéfinit totalement les cotes de performance individuelle (Player Props). Les bookmakers ne se contentent plus d'évaluer la dynamique globale d'une équipe. Ils ajustent en temps réel la probabilité qu'un attaquant spécifique cadre son prochain tir, en croisant sa vitesse instantanée avec sa position exacte sur le terrain pour lisser le risque financier avec une précision redoutable.
L'intégration des données biométriques et de la fatigue
Aujourd'hui, le rythme cardiaque ou la charge musculaire d'un joueur ne relèvent plus du simple suivi médical. Ces métriques physiologiques agissent désormais comme de puissants labels de santé pour nourrir les algorithmes de régression en temps réel.
En croisant ces signaux vitaux avec l'historique des performances, les modèles prédictifs identifient le point de rupture physique exact d'un athlète. Cette lecture biométrique explique la volatilité extrême des cotes dans les ultimes minutes d'une rencontre. Si le capteur d'un meneur de jeu indique un épuisement critique, la probabilité de victoire attendue de son équipe s'effondre instantanément sur les écrans des bookmakers.
La maîtrise de ces architectures complexes nécessite d'ailleurs d'explorer les rouages du Machine Learning et pronostics sportifs : le guide complet 2026 pour saisir comment la machine pondère chaque battement de cœur.
Cependant, cette captation intime soulève un défi éthique sans précédent. L'exploitation commerciale de la biologie des sportifs flirte dangereusement avec les limites de la vie privée. Des institutions garantes des libertés numériques, à l'image de la CNIL, surveillent de très près cette marchandisation des données corporelles sensibles par l'industrie du pari.
Synthèse des impacts économiques et opérationnels du machine learning
Voici comment l'intégration des algorithmes prédictifs bouleverse l'industrie financière du pari sportif en 2026.
- La transition des statistiques traditionnelles vers l'apprentissage supervisé (XGBoost, LightGBM) redéfinit totalement la justesse des probabilités sportives.
- L'ingestion continue de données étiquetées offre aux bookmakers une lecture prédictive infaillible pour ajuster leurs lignes de cotes.
- Cette hyper-réactivité technologique engendre une réduction de 15 à 25 % de l'exposition au risque sur les sessions de Live Betting.
- L'automatisation de la gestion du risque permet désormais de détecter et de limiter instantanément les parieurs professionnels.
- Propulsé par ces innovations, le marché de l'IA appliquée au secteur atteint la valorisation record de 12,7 milliards de dollars en 2026.
- Cette asymétrie algorithmique croissante oblige les autorités de régulation, à l'image de l'ANJ, à repenser le cadre légal du secteur.
IA explicable (XAI) : répondre aux exigences de l'IA Act européen
Restreindre le compte d'un parieur gagnant sur un simple soupçon algorithmique n'est plus toléré en 2026. Avec l'entrée en vigueur des exigences de l'IA Act au 2 août 2026, les opérateurs doivent justifier chaque limitation de mise ou suspension de profil avec une clarté absolue.
Les modèles de Machine Learning ultra-performants, comme les réseaux de neurones ou le Gradient Boosting, souffrent d'un défaut majeur : ce sont des boîtes noires. Pour décrypter leurs décisions, les bookmakers déploient désormais l'IA explicable (XAI). Cette surcouche technologique agit comme un traducteur instantané. Elle isole précisément la donnée étiquetée qui a déclenché l'alerte, qu'il s'agisse d'une anomalie sur un Value Bet ou d'un schéma de mise suspect en direct.
Cette transparence chirurgicale est devenue une obligation légale face au profilage automatisé. Les gendarmes du secteur, à l'image de l'Autorité Nationale des Jeux (ANJ) ou de la UKGC britannique, exigent des audits limpides. Si un algorithme de régression identifie un comportement à risque, l'opérateur doit prouver que la sanction repose sur des critères mathématiques objectifs, garantissant ainsi une gestion du risque équitable et conforme aux droits des utilisateurs.
Questions fréquentes sur l'apprentissage supervisé dans les paris
- Qu'est-ce que l'apprentissage supervisé apporte réellement à l'analyse des cotes ?
- Contrairement aux modèles statistiques classiques comme la loi de Poisson, l'apprentissage supervisé permet d'analyser des millions de variables en temps réel. Il apprend à partir de données historiques étiquetées pour identifier des corrélations complexes et imprévues, offrant ainsi une précision supérieure dans l'ajustement des cotes.
- Pourquoi les algorithmes comme XGBoost remplacent-ils les méthodes traditionnelles ?
- Les méthodes traditionnelles sont souvent trop rigides face à la dynamique imprévisible du sport. Des architectures comme XGBoost ou LightGBM excellent dans la gestion de données non linéaires et contextuelles, permettant aux bookmakers de modéliser le risque avec une granularité chirurgicale à chaque milliseconde.
- Les données étiquetées sont-elles indispensables pour ces modèles ?
- Absolument. L'apprentissage supervisé repose sur la qualité et la structure des données d'entraînement. Sans un étiquetage rigoureux des événements passés (passes, blessures, météo, etc.), l'algorithme ne peut pas apprendre les scénarios complexes nécessaires à une prédiction précise.
- Le trading algorithmique est-il devenu la nouvelle norme ?
- Oui. La vitesse d'exécution et la puissance de calcul des machines ont relégué l'intuition humaine au second plan. Le marché est désormais dominé par des systèmes qui ajustent les probabilités instantanément, rendant l'analyse manuelle obsolète pour le calcul des valeurs absolues.
Conclusion : l'efficience du marché face à l'asymétrie algorithmique
La mutation technologique des plateformes de paris est désormais achevée en cette année 2026. L'ingestion massive de données étiquetées par des modèles prédictifs ultra-véloces a définitivement relégué les vieilles formules statistiques aux oubliettes.
Face à cette puissance de calcul, le parieur humain se heurte à un mur de précision. La quête romantique du Value Bet s'évapore inexorablement. Les algorithmes de Gradient Boosting ajustent les lignes en quelques millisecondes avec une telle acuité que dénicher une faille de cotation relève aujourd'hui de l'exploit absolu.
Cette asymétrie annonce une dynamique inéluctable. D'ici 2030, le trading sportif et la bourse traditionnelle ne feront plus qu'un. Les opérateurs calquent déjà leurs infrastructures de gestion du risque sur celles des marchés financiers, transformant chaque événement athlétique en un produit dérivé ultra-liquide et impitoyablement efficient.
Farid Madena, 40 ans, combine une sagesse trempée par les années et une éternelle jeunesse d’esprit. Originaire du Maghreb mais avec un penchant pour la découverte mondiale, il dévoile des histoires et des analyses aussi variées que fascinantes. Farid aborde chaque sujet avec une passion et une précision inégalées. Son mantra ? « Chaque jour offre une leçon, chaque histoire une aventure. »